Ordina con una rete neurale


15

Le precedenti sfide del golf della rete neurale ( questa e quella ) mi hanno ispirato a porre una nuova sfida:

La sfida

Trova la più piccola rete neurale feedforward tale che, dato qualsiasi vettore di input 4-dimensionale (un',B,c,d) con voci intere in [-10,10] , le uscite di rete ordinare(un',B,c,d) con un errore di coordinate strettamente inferiore a 0.5 .

ammissibilità

Per questa sfida, una rete neurale feedforward è definita come una composizione di strati . Uno strato è una funzione L:Rn→Rm che è specificata da una matrice UN∈Rm×n di pesi , un vettore B∈Rm di distorsioni e una funzione di attivazione f:R→R che viene applicata coordinata- saggio:

L(X): =f(UNX+B),X∈Rn.

Poiché le funzioni di attivazione possono essere regolate per qualsiasi attività, è necessario limitare la classe di funzioni di attivazione per mantenere interessante questa sfida. Sono consentite le seguenti funzioni di attivazione:

  • Identità. f(t)=t

  • Relu. f(t)=max⁡(t,0)

  • SoftPlus. f(t)=ln⁡(et+1)

  • Tangente iperbolica. f(t)=tanh⁡(t)

  • Sigma. f(t)=etet+1

Complessivamente, una rete neurale ammissibile assume la forma LK∘LK-1∘⋯∘L2∘L1 per alcuni K , dove ogni strato Lio è specificato dai pesi UNio , bias Bio e una funzione di attivazione fio dall'elenco sopra. Ad esempio, è ammessa la seguente rete neurale (sebbene non soddisfi l'obiettivo prestazionale di questa sfida, può essere un gadget utile):

[min(un',B)max(un',B)]=[1-1-12-121-11212]ReLU[1212-12-121-1-11][un'B]

Questo esempio mostra due livelli. Entrambi i livelli hanno un bias zero. Il primo livello utilizza l'attivazione ReLU, mentre il secondo utilizza l'attivazione dell'identità.

punteggio

Il tuo punteggio è il numero totale di pesi e distorsioni diversi da zero .

(Ad esempio, l'esempio sopra ha un punteggio di 16 poiché i vettori di polarizzazione sono zero.)

2
@ Elettore ravvicinato: cosa non è esattamente chiaro? Non credo che nessuna delle precedenti sfide della NN sia stata così ben specificata.
— Flawr,

1
No: non è possibile saltare le connessioni.
— Dustin G. Mixon,

1
@ DustinG.Mixon In realtà ho appena trovato un approccio per il massimo / minimo che utilizza solo 15 pesi anziché 16, ma è notevolmente meno elegante :)
— flawr

3
Questa è una sfida ben specificata che penso possa servire da modello per le future sfide della rete neurale.
— xnor

1
et

Risposte:


13

Ottava , 96 88 87 84 76 54 50 pesi e inclinazioni

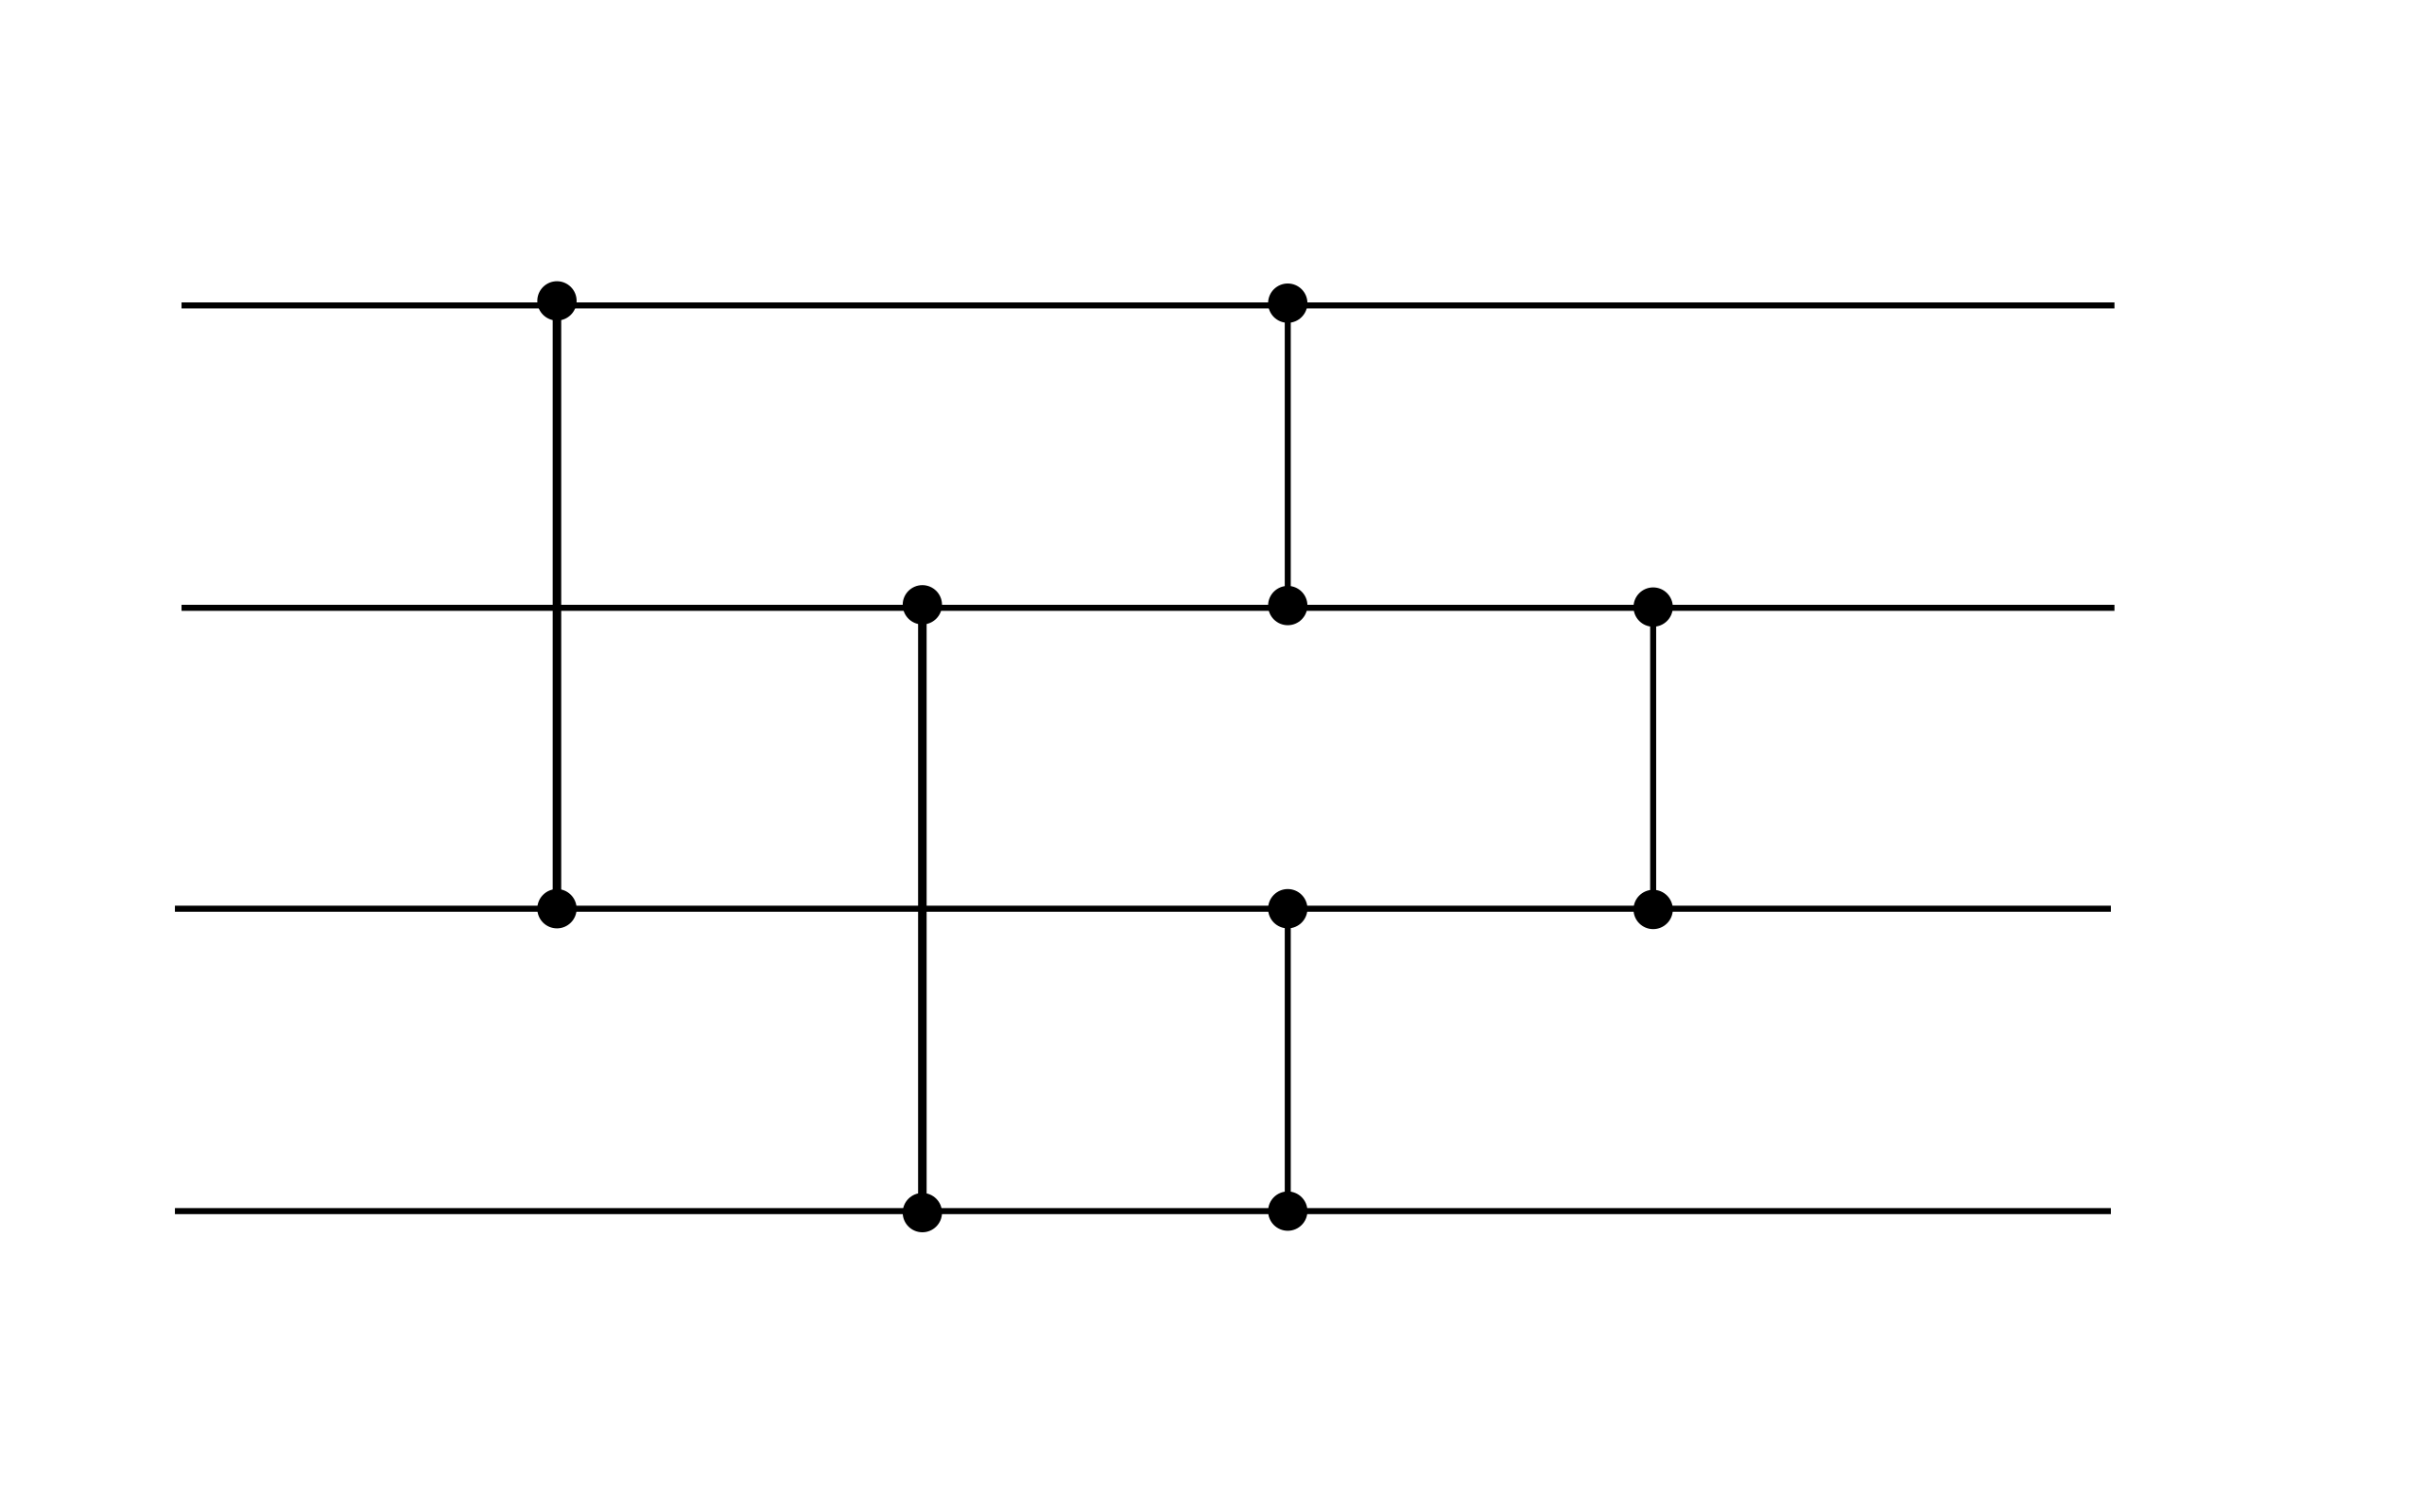
Questa rete neurale a 6 strati è essenzialmente una rete di smistamento in 3 fasi costruita da una rete min/ maxcomponente molto semplice . È fondamentalmente la rete di esempio di Wikipedia come mostrato di seguito, con una piccola modifica: i primi due confronti sono fatti in parallelo. Per aggirare i numeri negativi attraverso la ReLU, aggiungiamo prima 100 e poi sottraggiamo nuovamente 100 alla fine.

Quindi questo dovrebbe essere considerato solo come una linea di base in quanto è un'implementazione ingenua. Tuttavia, ordina tutti i numeri possibili che non hanno una grandezza troppo grande perfettamente. (Possiamo regolare l'intervallo sostituendo 100 con un altro numero.)

Provalo online!

max / min-componente

Esiste un modo ( molto meno elegante , più elegante ora, grazie a @xnor!) Per trovare il minimo e il massimo di due numeri usando meno parametri:

min=un'-ReLU(un'-B)max=B+ReLU(un'-B)

Ciò significa che dobbiamo usare molti meno pesi e distorsioni.

Grazie @Joel per aver sottolineato che è sufficiente rendere tutti i numeri positivi nel primo passo e invertirlo nell'ultimo, il che rende -8 pesi. Grazie @xnor per aver sottolineato un metodo max / min ancora più breve che rende -22 pesi! Grazie @ DustinG.Mixon per la punta di combinare alcune matrici che si traducono in altri -4 pesi!

function z = net(u)
a1 = [100;100;0;100;100;0];
A1 = [1 0 0 0;0 0 1 0;1 0 -1 0;0 1 0 0;0 0 0 1;0 1 0 -1];
B1 = [1 0 -1 0 0 0;0 0 0 1 0 -1;0 1 1 0 0 0;0 0 0 0 1 1];
A2 = [1 0 0 0;0 1 0 0;1 -1 0 0;0 0 1 0;0 0 0 1;0 0 1 -1];
A3 = [1 0 -1 0 0 0;0 1 1 0 0 0;0 0 0 1 0 -1;0 1 1 -1 0 1;0 0 0 0 1 1];
B3 = [1 0 0 0 0;0 1 0 -1 0;0 0 1 1 0;0 0 0 0 1];
b3 = -[100;100;100;100];
relu = @(x)x .* (x>0);
id = @(x)x;
v = relu(A1 * u + a1);
w = id(B1 * v) ;
x = relu(A2 * w);
y = relu(A3 * x);
z = id(B3 * y + b3);
% disp(nnz(a1)+nnz(A1)+nnz(B1)+nnz(A2)+nnz(A3)+nnz(B3)+nnz(b3)); %uncomment to count the total number of weights
end

Provalo online!


1
Gli offset costanti vengono sostanzialmente utilizzati per rendere gli ingressi non negativi. Una volta fatto nel primo strato, tutte le uscite intermedie dei blocchi di confronto non sono negative e è sufficiente ripristinarlo solo nell'ultimo livello.
— Gioele,

1
Potresti ottenere un gadget min-max più breve con (a - relu(a-b), b + relu(a-b))?
— xnor

@joel Oh ora capisco, ha molto senso :)
— Flawr,

@xnor Grazie mille che fa la differenza !!!!
— flawr,

1
Nitpick non pertinente: il punteggio per il primo bias è nnz (A1 * a0), non nnz (a0). (Oppure dobbiamo pagare il prezzo di una matrice di identità.) Questi numeri sono gli stessi in questo caso.
— Dustin G. Mixon,
Utilizzando il nostro sito, riconosci di aver letto e compreso le nostre Informativa sui cookie e Informativa sulla privacy.
Licensed under cc by-sa 3.0 with attribution required.